科技资讯
采购同事最近反复问同一个问题:新平台号称每美元推理吞吐大幅提升,我们的预算到底按哪个口径报?
英伟达围绕 AI 内存瓶颈发布的技术解读提供了一组对照:每 GPU 的 HBM 容量只增约 3%,而每美元智能体吞吐量最高提升 30 倍【1】。数字很有冲击力,但对一家真要把钱花出去的中国企业来说,关键不在峰值,而在这 30 倍发生在哪个环节、你的业务能拿到多少。
这篇不复述发布内容,只做三件事:把可比的口径拉齐,把成本结构拆开,给一份 90 天内能验收的动作清单。见下文配图。
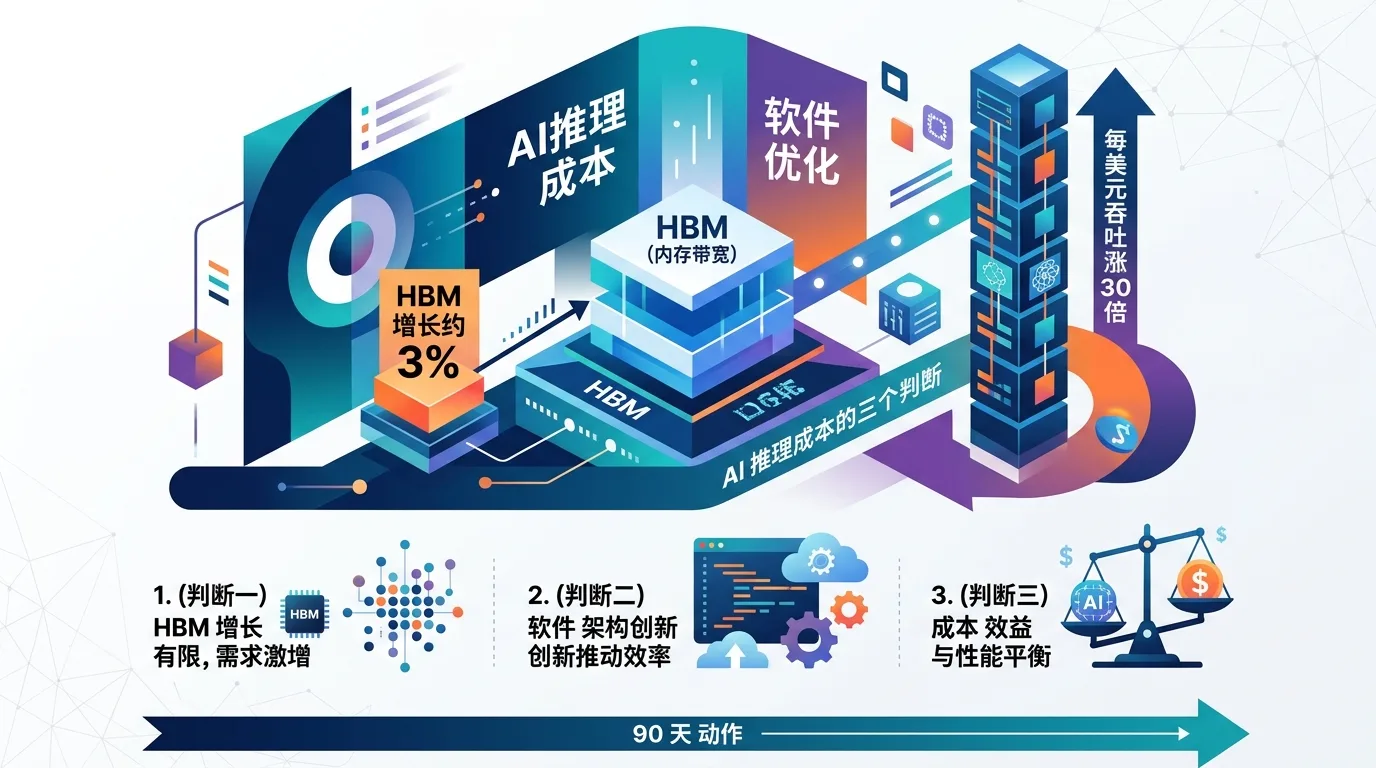
图:示意图(AI 生成,非原文截图;模型 nano-banana-2)。仅作阅读辅助,事实以正文与参考文献为准。
一、先拉齐口径:三个数字各自的前提
| 指标 | 对照平台 | 前置条件 |
|---|---|---|
| 每美元智能体吞吐最高提升 30 倍 | Vera Rubin NVL72 对比 GB300 NVL72 | 每用户每秒 125 token |
| 每美元吞吐最高提升 10 倍 | GB300 NVL72 对比 H200 | 每用户每秒 100 token |
| 每 GPU 的 HBM 容量增约 3% | — | — |
以上三行均出自英伟达援引的 SemiAnalysis AgentX 基准【1】【3】。
把这三行摆在一起读,结论其实很清楚:被放大的是比率型指标,不是容量本身。而比率天生依赖前置条件——交互速率一变,倍数就跟着变。因此它适合当方向信号,不适合直接当预算输入【3】。
二、成本长在哪:一个变量不受预算约束的结构问题
推理时显存要装两类东西。一类是模型参数,装载一次、基本恒定,可以提前算进资本开支;另一类是这段对话的 KV 缓存,随请求长度和轮次浮动,属于运行期的变动成本【1】。
智能体把后者放大了。一次任务里模型要反复调用工具、带着历史往下走,公开资料提到的极端情形需要处理约 300 万 token 的上下文【1】;RAG 又把企业文档拼进提示词,占用进一步抬高【1】。
结果是一种错位:预算按卡数批,账单按上下文长度长。业务侧感受到的是「更好用了」,财务侧看到的是「同样的机器,能服务的量下来了」。
编辑建议:把「平均上下文长度」和「单会话工具调用轮次」两个数放进周报,与调用量并列。这两个指标不需要新建系统,从推理网关日志里就能取。
三、英伟达的答案:不是把仓库盖大,而是分层
公开解读里有一个比喻:HBM 像仓库,带宽像装卸口;口子不够快,仓库再大也运不出去,这就是常说的「内存墙」【1】【2】。对企业侧的含义是:容量可以买,吞吐必须调,两者不是一回事。
沿这个思路,这次的技术路线大致分四层【1】【2】:
- 数值格式层:用 NVFP4 这类低精度格式压缩模型权重与 KV 缓存,从源头减少字节数;
- 芯片之间:在 NVL72 系统中把权重摊到最多 72 颗 GPU,单卡压力被分散;
- CPU 就近层:借助 Vera CPU 的大容量 LPDDR,把「暂时不用」的上下文放在离 GPU 较近的位置;
- 软件调度层:由 Dynamo 把闲置上下文迁入 CMX 上下文存储,需要时再取回;RAG 索引则更适合留在 CPU 与存储侧。
对技术负责人的一句话总结:HBM 正在从「什么都装」变成「只装最热的」。这个转变主要靠软件完成,也正因如此,它不必等新硬件到货才能开始。
四、古令乐的三个落地判断
判断一:短期省钱靠软件,长期省钱靠架构。 会话裁剪、历史摘要、工具返回值截断、召回条数设上限,这些动作不产生采购单,却直接压低 KV 缓存占用。先做这些,再谈换平台,顺序反了会白花钱。
判断二:采购口径要从「元/卡」换成「元/有效 token」。 并且必须带三个前置条件:上下文长度分布、并发用户数、每用户 token 速率。缺任何一项,两份报价都不可比。
判断三:绑定点上移。 当调度类组件进入推理链路,替换成本的性质就变了——以前是换硬件,现在是换一套栈【2】。合同里至少留三条:配置可导出、数据可带回、旧链路可回退。
五、90 天动作清单
- 第 1–2 周|测量。 抓 7 天真实流量,输出上下文长度分布(P50/P90/P99)、工具调用轮次分布、峰值显存占用曲线。没有这三个分布,后面所有讨论都是猜。
- 第 3–6 周|治理。 上会话摘要与截断策略,给 RAG 召回加条数上限。每项改动做对照实验,同时记录 token 成本与业务效果,只看向成本一侧会翻车。
- 第 7–10 周|分层试点。 选一条非核心业务,把冷上下文与 RAG 索引迁到 CPU 与存储侧,重点观察首 token 延迟与缓存命中率,别只看吞吐。
- 第 11–13 周|改合同与预算表。 把 POC 的前置条件写进合同附件,预算表增加「每万次任务成本」一行,代替「GPU 台数」作为主指标。
六、四个必须写进会议纪要的风险
- 供给风险。 关于 HBM 供应偏紧、价格上行的判断,据公开报道仍在延续【1】。报价有效期会变短,长约与现货的配比需要财务提前介入。
- 口径风险。 厂商援引的第三方基准不能当验收标准,合同中应约定以自有业务负载复测的条件与周期【3】。
- 绑定风险。 调度组件进入链路后的可迁移性问题,处理思路见第四节的判断三【2】。
- 合规风险。 RAG 把内部资料带进提示词,数据分级、上下文留存与外溢边界要同步定,不要等降本做完再补。
结语
等显存降价,是最省事也最被动的一种选择。更现实的顺序是:先量上下文,再治上下文,然后把内存分层,最后才讨论扩容。账本最终记的不是你买了多少卡,而是每一字节显存换回了多少有效输出。
参考文献
【1】英伟达破局 AI 内存瓶颈:HBM 仅增约 3%,每美元智能体吞吐量最高提升 30 倍 — https://www.ithome.com/1/023/025.htm 【2】编辑注:NVFP4、NVL72 权重分散、Vera CPU 的 LPDDR 缓冲、Dynamo 与 CMX 上下文存储等技术要点转引自【1】,分层解读及迁移、合同建议为古令乐编辑部的补充分析 — https://www.ithome.com/1/023/025.htm 【3】编辑注:SemiAnalysis AgentX 基准数据由英伟达在技术解读中援引,古令乐未做独立验证;口径提醒与验收建议为基于该来源的二次解读 — https://www.ithome.com/1/023/025.htm 【4】编辑注:文中 90 天动作清单、指标建议与采购口径均为古令乐编辑部的实操建议,不属于来源内容 — https://www.ithome.com/1/023/025.htm