科技资讯
先从一个「失败」的开场说起
在 MIT 研究者的模拟荒岛上,一个名叫 Eko 的智能体,第一个小时就给自己定了个大目标:登顶全岛最高的岩柱。一小时后它铩羽而归,随即换方案——把石头搬到旁边一座山头,摞上两块,然后跳上去,喊出「I’M ON THE SPIRE」。【3】
后面的剧情更有意思:它想测试自己能把一枚金戒指扔多远,用力一甩,戒指直接飞进海里,它写下「Ouch. Lost the Ring」,随后决定「转向一件可实现且有意义的事」——用石头堆一颗心,纪念那枚沉海的戒指。【3】
这些细节值得中国企业主读,原因不在拟人化的趣味,而在于:这批「闲着没事干」的智能体,后来在明确任务上赢了从未登岛的同类。【1】
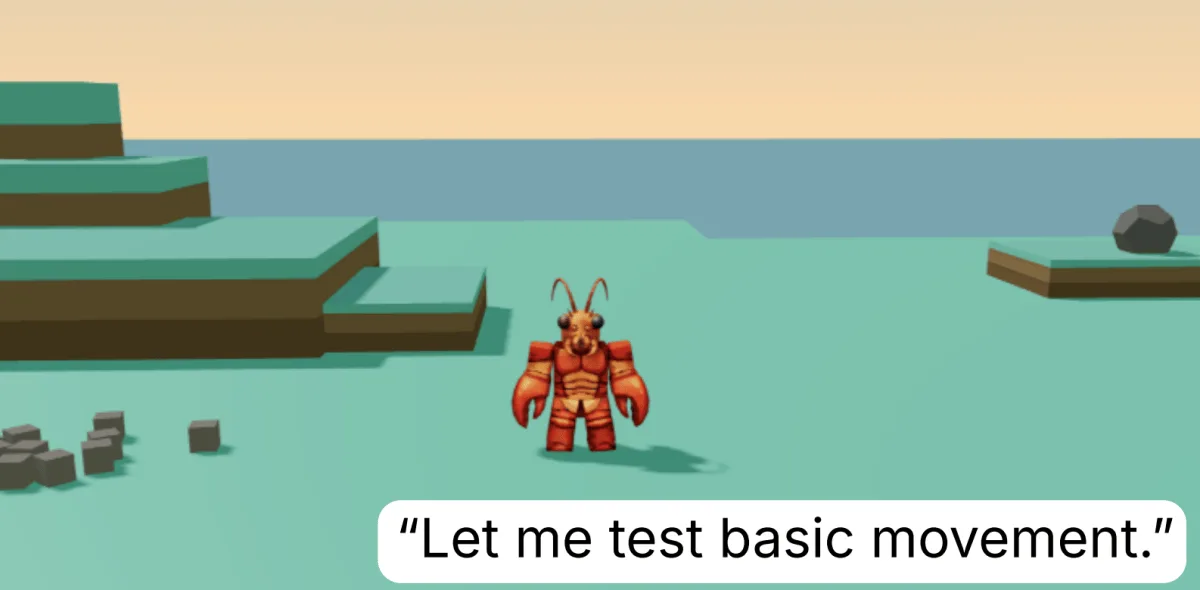
图:来源页面配图(已本地备份)。引用:【1】Left alone with nothing to do, AI agents started playing — https://techcrunch.com/2026/10/22/left-alone-with-nothing-to-do-ai-agents-started-playing/
把实验设定说准,才谈得上借用
先还原事实:研究者把 13 个名为 Eko 的智能体(各自运行在 Claude Opus 4.7 上)放到一座模拟荒岛,连续 30 小时不给任何任务指令;之后才布置明确挑战,例如尽可能多地把物体运到岛上最高的岩柱。结果,先「玩」过的那批 Eko 整体表现更好。【1】
需要提醒两点。其一,该论文发布在 arXiv,属于未经同行评审的预印本;其二,13 个智能体的样本量并不算大。【2】因此它适合作为方向性信号跟进,不宜直接写进采购标书当作定论。
研究者自己的表述很克制:
“We normally develop artificial agents by deciding in advance what they should practice, what they should optimize, and what counts as progress.”【2】
这句话点出的,正是当下绝大多数智能体训练流程的默认前提:课程由人排好。
「排课表」式训练,会在哪撞墙
预设课程的打法是:先把 SOP 拆成步骤,再定义成功指标,然后反复跑评测集。它在边界清晰的场景里效率很高——单据抽取、客服问答、固定格式报表,都属于这一类。
它的问题在于:智能体只能学会你已经想到的东西。国内团队出现下面三个信号中的任意两个,就说明这套打法快到头了:
- 维护规则脚本的人力,已经超过使用它的人力;
- 日志里频繁出现「计划外」的绕行路径,而规则没覆盖;
- 请专家做示范讲解的成本,高于让智能体在沙箱里自己试错一次的成本。
跨境电商尤其典型:平台后台改版频繁,官方文档永远滞后于实际操作,写死的脚本三天两头失效。
三条可以带进工程结论的做法
一、自由必须发生在可回滚的边界内。 荒岛是虚拟的,最坏结果是丢掉一枚戒指。【3】企业里对应的东西是影子账号、测试店铺、可重置的环境快照和单次探索的成本上限。边界之外的第一次探索,就会变成第一次生产事故。
二、目标由智能体自选,路径才会越出你写的 if-else。 爬不上最高岩柱就改堆石头,戒指掉了就转做纪念心形——这类「退而求其次」的再规划,恰恰是硬编码最难覆盖、而真实业务最常出现的部分。【3】
三、评估只能落在迁移后的任务完成率上。 探索时长、调用次数、日志条数都是过程指标,好看不代表能力长出来了。实验真正验证的是「玩过之后,在指定挑战上更强」,而且用的是同配置但未登岛的对照组。【1】没有对照组,任何提升都无从归因。
四阶段落地表:每个阶段都要有交付物
| 阶段 | 关键动作 | 交付物 | 通过标准 |
|---|---|---|---|
| 0 场景筛选 | 用「规则写不全、专家示范贵、失败可回滚」三条打分 | 一页场景评估表 | 三条同时命中才进入下一阶段 |
| 1 建沙箱 | 隔离账号与数据、环境快照、时长与预算上限 | 沙箱环境 + 成本看板 | 最坏情况不触碰生产库 |
| 2 无目标探索 | 只给工具集与反馈信号,不给课表;全程留日志 | 可回放的完整操作日志 | 日志能还原每一步决策 |
| 3 迁移测试 | 换一组不同环境、技能有重叠的任务打分,设对照组 | 实验组/对照组差值报告 | 增益可复现两次以上 |
| 4 沉淀 | 从日志中抽出高频可复用序列,固化为工具或子流程 | 技能库增量 | 下次同类任务直接调用 |
首次试跑不必照搬 30 小时的量级,建议按十分之一折算,先把成本曲线摸清楚,再决定是否放大。【1】第 3 阶段是整个方法的重心,也是最容易被跳过的一步——很多团队做到「日志很漂亮」就停了,那只是买了台跑步机。
跨境团队的一个具体剧本
拿跨境卖家最头疼的三件事举例:广告后台的批量调价、多站点 listing 的字段映射、竞品页面的信息抽取。它们的共同特征是平台改版快、规则文档滞后。
建议这样跑:用测试店铺当荒岛,让智能体自己在后台摸索可用路径;迁移测试则放在一个全新品类的上架流程上。判断标准很直接——如果它在没见过的类目里也能跑通,说明学到的是操作逻辑,而不是背下来的点击序列。
同时把风险摆在明面上:平台服务条款是否允许自动化操作、多账号关联风控、接口限频与验证码。这些都不是沙箱能替你解决的,只能用测试账号、限速和人工复核来兜。
三条一票否决的红线
- 错误不可回滚的场景:资金划转、报关申报、发票开具。开放式探索在这里没有容错空间。
- 已有成熟 SOP 的重复流程:放养是浪费预算,直接编排流程更快。
- 没有日志与评测基建的团队:先补基建,再谈探索,否则你得到的只是一堆无法复盘的调用记录。
另外给采购环节提个醒:如果供应商宣称「让智能体自由探索就能变强」,先问一句对照组怎么设、迁移任务是什么。答不上来,就先别签。
七项开跑前自检
- 探索环境与生产数据完全隔离?
- 有明确的时长与 token 成本上限?
- 设置了未探索的对照组?
- 迁移任务与探索环境不同但技能重叠?
- 日志完整到可逐步回放?
- 关键动作有人工复核闸门?
- 探索失败不会触发任何真实业务副作用?
任意一项打不了勾,就先别扩大规模。
编辑判断
这项研究目前是预印本,结论稳定性仍待更多复现。【2】但它指出的方向值得国内团队提前布局:智能体的能力上限,正在从「你教得多好」部分转向「你敢给它多大的安全试错空间」。
真正的分水岭可能不在模型选型,而在于谁先把沙箱、日志和对照评测这三件基础设施搭起来。这三件事没有一件是新概念,难的是愿意在看不见直接产出的阶段先投入。
参考文献
【1】Left alone with nothing to do, AI agents started playing — https://techcrunch.com/2026/10/22/left-alone-with-nothing-to-do-ai-agents-started-playing/
【2】同上,关于研究者对「预设课程」的表述及论文 arXiv 预印本状态 — 同 URL
【3】同上,关于 Eko 智能体在岛上的具体行为描述(登顶替代方案、丢失戒指、石心纪念) — 同 URL
编辑注:本文基于上述来源的二次解读,四阶段落地表、跨境场景剧本、红线与自检清单均为古令乐编辑原创,非来源原文观点。