科技资讯
一条云厂商的算力公告,多数人只盯着一个数字:买了多少卡。甲骨文这次真正变了的地方不在采购量,而在结构——它一边把英伟达最新一代 Vera Rubin 服务器推到「数吉瓦级」的部署规模,一边第一次把谷歌 TPU、Cerebras、SambaNova 的芯片写进自家云的产品目录【1】。
买得更多,同时买得更杂。这两件事同时发生,才是这条消息的分量所在。
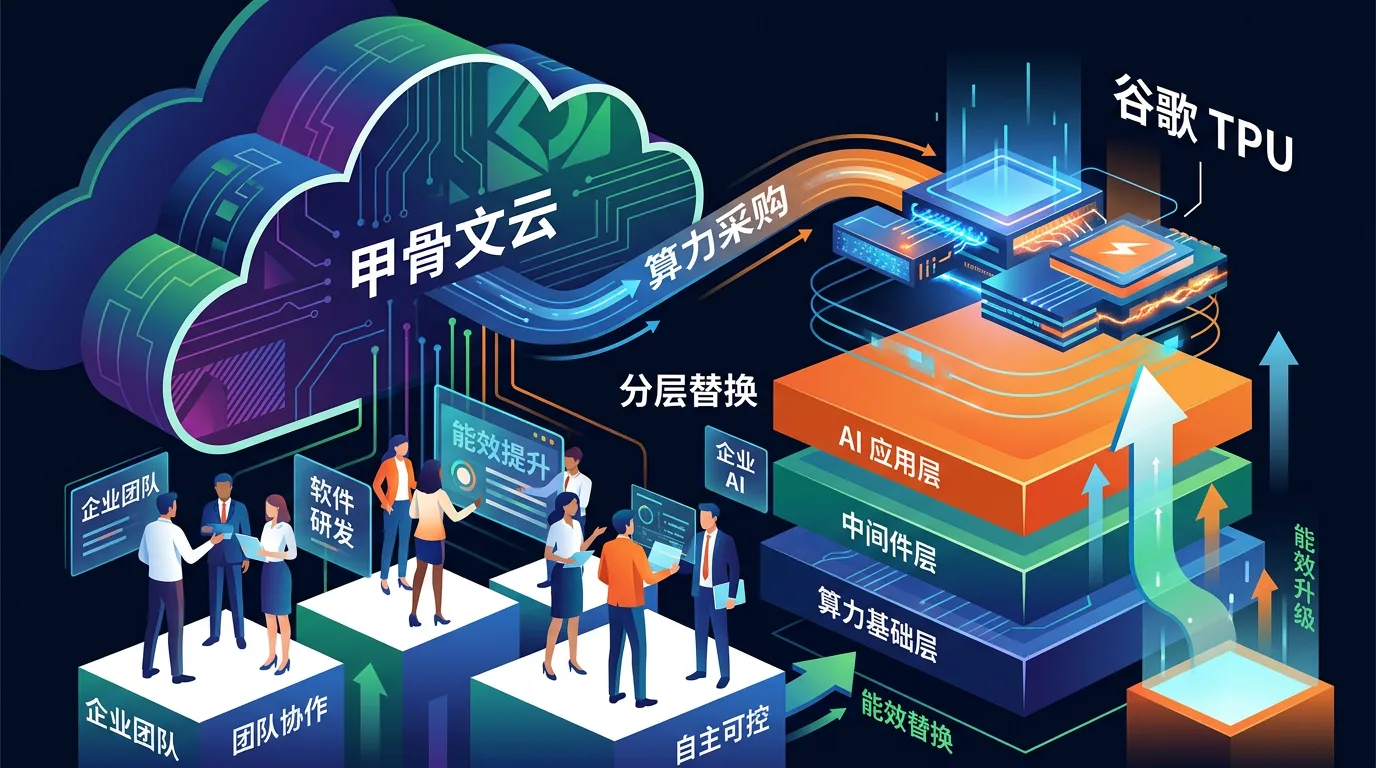
图:示意图(AI 生成,非原文截图;模型 nano-banana-2)。仅作阅读辅助,事实以正文与参考文献为准。
一、三个动作连起来看,其实是同一件事
公告里的信息可以拆成三层来读。
计算层,继续重仓英伟达。 甲骨文将大规模部署 Vera Rubin 系统,规模达到「数吉瓦级」,双方未披露交易金额【1】。可作参照的是,黄仁勋此前公开表示,Vera Rubin 每吉瓦部署可为英伟达带来最高 400 亿美元收入【1】——这是厂商口径的收入测算,不是本次成交额,不宜直接相乘当合同规模看。
网络层,换回自研。 即便是基于英伟达芯片的系统,甲骨文也打算弃用英伟达的部分网络芯片,改用自家 Acceleron 网络芯片【1】。
推理层,引入外部供应商。 甲骨文计划向客户提供谷歌 TPU,同时纳入英特尔支持的 SambaNova 与专注推理环节的 Cerebras 芯片【1】。
三条放在一起,共同点只有一个:把原本打包出售的算力栈,拆成计算、网络、推理几个可以分别替换的模块,每一层都保留自研或第二供应商的余地。这不是简单的「货比三家」,而是在架构层面提前给自己留出腾挪空间。
二、为什么是现在:训练集中,推理分散
公开报道给出的行业格局判断很直接:英伟达在 AI 模型训练市场仍占主导,而推理市场的竞争格局更加分散,参与者更多【1】。甲骨文选在这个时点做组合,踩的正是这条分界线。
推理和训练的经济学完全不同。训练追求单集群峰值性能和生态成熟度,换芯片的迁移成本极高;推理则是高频、长周期、成本敏感的运营型支出,一旦模型定型,单位 token 的成本就成为可被反复优化的变量。当智能体类应用把调用量推高,推理侧的性价比讨论自然会从「要不要换」变成「怎么换」。
Cerebras 首席执行官 Andrew Feldman 对路透社的表述,可以看作供给侧的旁证:这类合作将大幅扩大其一级客户群体,产品正以大规模部署的方式进入其他公司的数据中心【1】。翻译成商业语言——专用推理芯片正在从「实验室选项」变成「机房里的常规采购项」。
三、两个容易被忽略的限定词:2027 与「谁来付钱」
第一个是时间。 甲骨文将成为谷歌之外第一家对外提供 TPU 的超大规模云服务商,但该服务预计 2027 年推出,并在多年内逐步扩大规模,覆盖训练、推理与智能体应用;谷歌第八代 TPU 分为面向训练的 TPU 8t 和面向推理的 TPU 8i【2】。也就是说,今天讨论的多元化,兑现期在下一个采购周期,而不是下个季度。
第二个是资金。 甲骨文尚未披露如何为这批芯片采购提供资金,公司在财报电话会上提到客户正越来越多地承担芯片采购费用,并预计 2027 财年相关支出约 900 亿至 950 亿美元【3】。这个体量说明,多元化不是靠省钱做出来的,而是靠更大的资本开支撑起来的。对云厂商是杠杆,对客户则很可能意味着定价结构变复杂——选择变多的同时,账单的构成也会变复杂。
四、对中国企业的三层影响
第一层,出海团队:多一个议价筹码,但现在还用不上。 在海外部署模型服务、又对单一 GPU 供应紧张的团队,可以把 OCI 未来公布的多芯片产品线写进供应商比价清单。但把 2027 年才上线的 TPU 服务当成明年的降本方案,是典型的预算踩空。
第二层,技术负责人:把「换芯片」改造成「换入口」。 最务实的准备不是现在去评估每一款芯片的算子覆盖率,而是在推理层加一层统一网关——对外保持 OpenAI 兼容接口,对内把模型加载、批处理策略、量化精度做成可配置项。后端从 A 芯片切到 B 芯片,理想状态下应当只是改一个 endpoint 和一组参数。这项工作与具体用哪家云无关,越早做完,未来选择权越大。
第三层,智算中心与服务器集成商:注意网络层这个信号。 甲骨文在英伟达系统上替换自研网络芯片这一动作【1】,指向的是一套组合里最容易被忽略、却常常牵动整体成本与交付节奏的环节。自研或第二供应商的策略是否适用于自身规模,需要按实际集群体量和运维能力核算,但「把网络层单独拿出来做供应风险评估」这件事,现在就可以进流程。
五、风险清单:选项不等于能力
时间错配。 可部署的英伟达新平台与 2027 年才推出的 TPU 服务之间,存在明显的时间差【2】,按「明年就能多芯片」编预算容易落空。
软件栈碎片化。 不同芯片对应不同编译器、算子库与并行策略,跨芯片调度能力需要企业自己建设,云厂商提供的是选项,不附带免费的迁移服务。
锁定对象转移。 从「锁定英伟达」变成「锁定某家云厂商的芯片菜单」,议价权并没有自动回到客户手里。
成本转嫁。 客户承担芯片采购费用的模式若扩散,算力支出会从按量计费向更复杂的承诺制、预付制演化【3】,财务模型需要重做。
合规变量。 跨境算力采购还叠加数据跨境与出口管制等不确定性,具体以官方口径和自身合规评估为准。
六、未来 6–12 个月,盯什么、做什么
**观察指标:**甲骨文投资者日是否给出多芯片采购的资本开支拆分【3】;是否出现第二家超大规模云厂商跟进供应谷歌 TPU;Cerebras、SambaNova 的一级客户名单是否继续扩容【1】;「客户承担采购费用」是否从个案变成行业惯例;国内云厂商是否推出对应的多芯片产品线表述。
**现在就能做的三件事:**把推理层与训练层在架构上解耦,并沉淀一份后端可替换的接口规范;预算按负载类型分列,而不是按供应商分列,训练锁长协、推理保留多源竞价空间;在架构评审清单里加一条固定问题——「如果明天这块芯片涨价或断供,我们多久能切走」。
以上是基于单条公开资讯的趋势推演,用于判断方向而非下定论【4】。真正值得记住的不是甲骨文买了多少芯片,而是它公开承认了一件事:在 AI 基础设施里,没有哪一层必须只有一个供应商。
参考文献
【1】甲骨文扩大与英伟达的芯片供应合作,同时引入谷歌 TPU 和 Cerebras 芯片 — https://www.ithome.com/1/018/728.htm 【2】同上,谷歌 TPU 供应范围、TPU 8t/8i 与 2027 年推出时间表部分 — https://www.ithome.com/1/018/728.htm 【3】同上,甲骨文资本开支指引与客户承担芯片采购费用部分 — https://www.ithome.com/1/018/728.htm 【4】编辑注:基于上述来源的二次解读、趋势推演与落地建议,不构成投资或采购建议 — https://www.ithome.com/1/018/728.htm